REGISTRO DE LABORATORIO / J-007 / VOZ LOCAL
De un ordenador preparado para robótica a un prototipo conversacional funcional.
La cabeza actual se basa en un NVIDIA Jetson Orin Nano Super con cámara Logitech C920, matriz de cuatro micrófonos Seeed Studio ReSpeaker XVF3800 y altavoces Creative Pebble V3. Estos dispositivos ya se habían puesto en funcionamiento individualmente. Esta fase hizo que el hardware de audio y el sistema local de IA participasen en un único sistema conversacional continuo.
El resultado es el primer ciclo de voz local funcional de Evopien: entrada de micrófono, reconocimiento de voz, razonamiento local de Qwen, síntesis de voz en flujo continuo, turnos sin pulsar botones e interrupción conversacional real funcionan ahora juntos en Jetson.
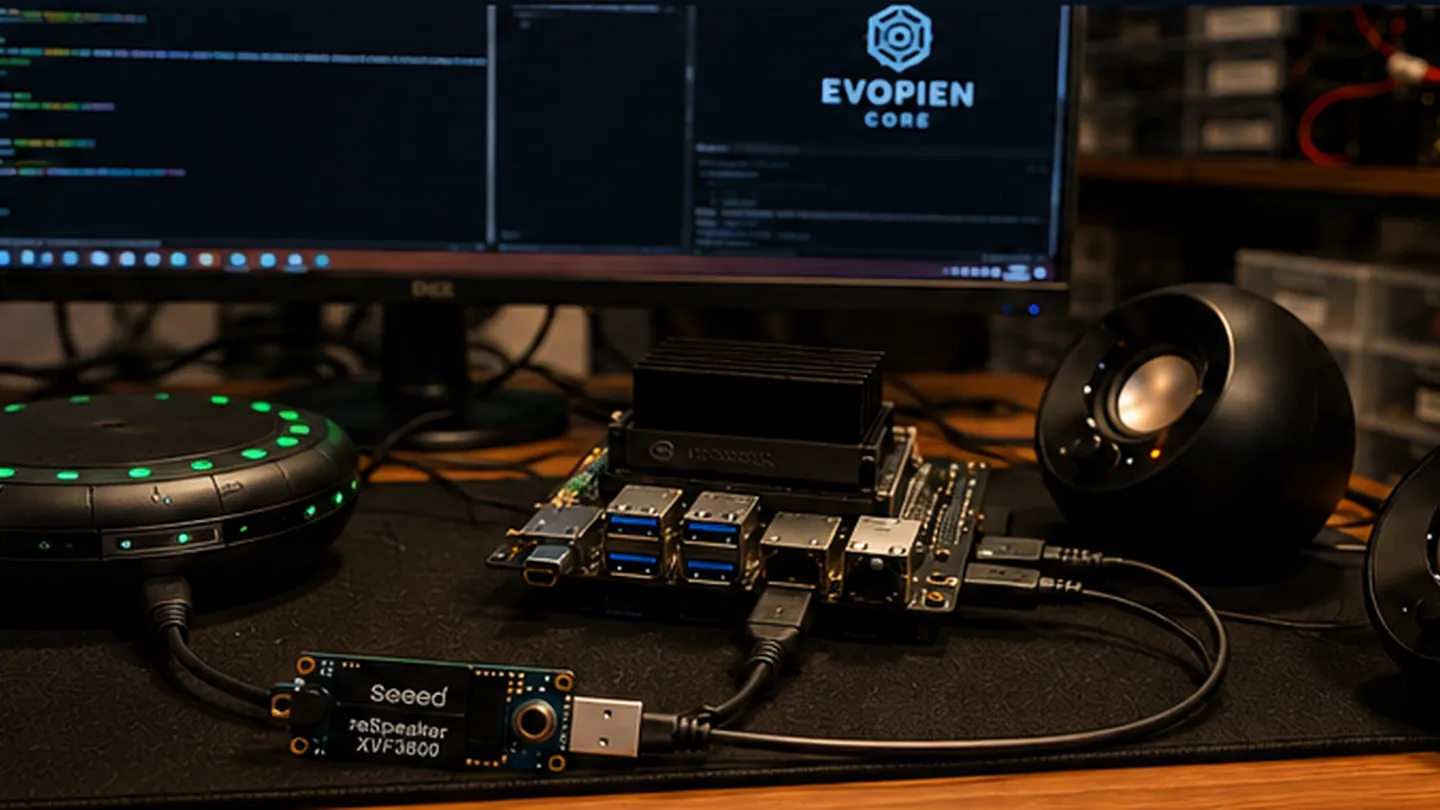
Ciclo de conversación local
La ruta completa ya se ejecuta localmente en Jetson.
whisper.cpp se encarga del reconocimiento de voz, Qwen3.5-4B se ejecuta localmente mediante llama.cpp y Piper genera la salida hablada. Qwen es el componente actual de lenguaje y razonamiento; no es la identidad de Evopien.
Micrófono ReSpeaker
        |
        v
reconocimiento de voz local
        |
        v
Evopien Core
        |
        v
Qwen3.5-4B
        |
        v
síntesis local de voz en flujo continuo
        |
        v
altavoces Pebble V3- Entrada de voz
- Matriz de micrófonos ReSpeaker XVF3800 con captura local
- Reconocimiento de voz
- Modelo base multilingüe de whisper.cpp, actualmente fijado al inglés para la estabilidad de la Alpha
- Razonamiento
- Qwen3.5-4B Q4_K_M mediante llama.cpp con ejecución en GPU
- Síntesis de voz
- Servicio local persistente de Piper con la voz en_GB-alan-medium
- Reproducción
- Creative Pebble V3 mediante la ruta de salida PipeWire/PulseAudio
- Límite de Core
- La identidad y el estado de relación y sesión permanecen separados del modelo de lenguaje reemplazable
Interacción sin pulsar botones
La conversación ya no depende de pulsar para hablar.
Evopien escucha el habla, detecta pausas y estima si la persona ha terminado realmente su idea antes de enviar el turno al modelo.
- El habla comienza de forma natural
El usuario habla sin pulsar una tecla ni mantener presionado un control para hablar.
- Se interpretan las pausas
Un silencio breve puede cerrar una frase terminada, mientras una idea incompleta puede permanecer abierta.
- Las pausas para pensar amplían el turno
Frases como «give me a moment» («dame un momento») o «let me think» («déjame pensar») pueden ampliar temporalmente la ventana de escucha en lugar de provocar una respuesta prematura.
- El turno resultante entra en Core
La transcripción actual solo pasa a la ruta del modelo local después de considerar completo el turno.
Interrupción durante el habla
Se puede detener a Evopien mientras habla.
Los micrófonos siguen escuchando durante la reproducción. El habla humana clara puede detener el audio actual, cancelar la generación activa del modelo de lenguaje y conservar el audio de la interrupción para transcribirlo en lugar de descartarlo.
Evopien: [hablando]

Usuario: Stop. («Para»).

Evopien: [en silencio]La voz actual de Piper/paplay se detiene cuando se detecta una interrupción válida.
Se cierra el flujo HTTP activo de llama.cpp y se cancela la tarea de generación abandonada.
La propia interrupción permanece disponible para transcripción y clasificación.
Intenciones de control como parar, esperar, mantenerse a la espera y similares pueden terminar el habla sin provocar otra respuesta innecesaria.
Un «go on» («continúa») posterior puede retomar el tema interrumpido utilizando el contexto temporal de sesión.
La siguiente intervención puede sustituir de inmediato el tema interrumpido por una nueva solicitud.
Flujo continuo en lugar de espera
Qwen, TTS y reproducción ahora se solapan.
La primera versión esperaba la respuesta completa del modelo antes de generar voz. El entorno actual transmite la salida del modelo y envía a Piper segmentos de tamaño de frase o cláusula mientras Qwen sigue generando el resto de la respuesta.
Generación de Qwen
      +
síntesis de voz
      +
reproducción de audio
Las mejores mediciones observadas desde el final del habla hasta el primer audio han alcanzado unos 1,7–1,9 segundos. El resultado varía con la detección de fin de turno, la transcripción y el contenido de respuesta, por lo que es una medición de desarrollo, no una garantía de latencia fija.
Contexto de trabajo, no memoria a largo plazo
El ciclo de voz solo recuerda temporalmente la conversación activa.
El entorno conserva actualmente ocho mensajes, unos cuatro intercambios, para seguir el tema activo y recuperarse tras una interrupción. Ese contexto desaparece al salir del ciclo de voz y deliberadamente no se presenta como memoria persistente gobernada de Evopien.
- Contexto actual
- Ocho mensajes temporales en el proceso de voz en directo
- Finalidad
- Seguir el tema activo, referencias sencillas y el comportamiento de interrupción y reanudación
- Persistencia
- Ninguna; el contexto de trabajo desaparece al salir del ciclo de voz
- Memoria futura
- Las propuestas del modelo de lenguaje requerirán reglas deterministas de clasificación, permisos, conservación y auditoría antes de almacenarse
- Objetivo de privacidad
- El contexto privado no autorizado debe bloquearse antes de facilitarse a cualquier modelo
- Límite de la afirmación
- El historial temporal de conversación no se describe como memoria de relación a largo plazo
Optimización del Jetson de 8 GB
El mismo modelo 4B deja ahora margen para la siguiente capa de percepción.
Jetson utiliza memoria unificada, por lo que el sistema operativo, el modelo en GPU, el sistema de voz y el futuro procesamiento visual compiten por los mismos 8 GB. La primera configuración completa de voz funcionaba, pero dejaba demasiado poco margen para visión.
Qwen3.5-4B Q4_K_M sigue siendo el modelo local actual.
Reducido desde la configuración anterior de voz de 2048 tokens para la carga actual de la Alpha.
Reducido desde 128 / 128 para disminuir la presión de memoria del entorno.
Mejora respecto a menos de 1 GB disponible en la configuración anterior de voz completa.
Se mantuvo margen de memoria física durante la prueba más exigente observada con esta configuración.
Intervalo típico observado de generación local durante las pruebas actuales de desarrollo.
Estado demostrado actual
Lo que realmente funciona ahora.
Este es el límite actual del desarrollo, no una afirmación sobre el humanoide terminado.
La identidad persistente de Evopien permanece separada del modelo actual.
Core actual resuelve el usuario creador y el contexto de relación y sesión.
El proveedor local llama.cpp se sitúa detrás de la abstracción de modelo existente.
El razonamiento textual local se ejecuta mediante llama.cpp con ejecución en GPU.
whisper.cpp y Piper proporcionan la ruta actual de reconocimiento y salida de voz.
Se han demostrado pausas adaptativas y esperas explícitas para pensar.
La salida en segmentos de cláusula solapa generación, síntesis y reproducción.
La reproducción y la generación abandonada del modelo pueden cancelarse mediante habla válida de interrupción.
El ciclo en directo mantiene un pequeño historial de trabajo para la continuidad conversacional.
El repositorio Core conservó nueve pruebas automatizadas superadas en este hito.
Límite conocido
La cámara funciona. La visión conversacional en directo todavía no.
Logitech C920 ya captura vídeo correctamente y la capacidad multimodal de Qwen se ha probado de forma independiente. El entorno de voz actual aún no captura un fotograma actual de la cámara ni lo incorpora al turno hablado en directo.
Por tanto, Evopien aún no puede responder con veracidad a «¿qué ves?» a partir de un fotograma actual durante una conversación normal. La memoria persistente gobernada de relaciones, la separación completa de privacidad multiusuario, una trazabilidad completa de auditoría de memoria, la comprensión continua de escenas, el reconocimiento facial, el movimiento facial con ESP32, el control de servos y cuerpo, la acción física autónoma y un cuerpo humanoide completo también son hitos futuros, no capacidades actuales afirmadas.